
DevOps-инженер: чем занимается и какая база нужна, чтобы начать
DevOps-инженер выстраивает путь приложения от изменения кода до работающего сервиса: автоматизирует сборку, проверки, развёртывание и откат. Он описывает инфраструктуру как код, использует контейнеры и наблюдает за состоянием системы после выпуска. Роль пересекается с администрированием и SRE, но отличается задачей сделать доставку изменений повторяемой для всей команды. Для входа обычно уже нужна база в разработке, операционных системах и сетях; доход зависит от масштаба инфраструктуры и ответственности.
 Автор: Александра СыщенкоАвтор об IT и профессиональном обучении · О редакции
Содержание
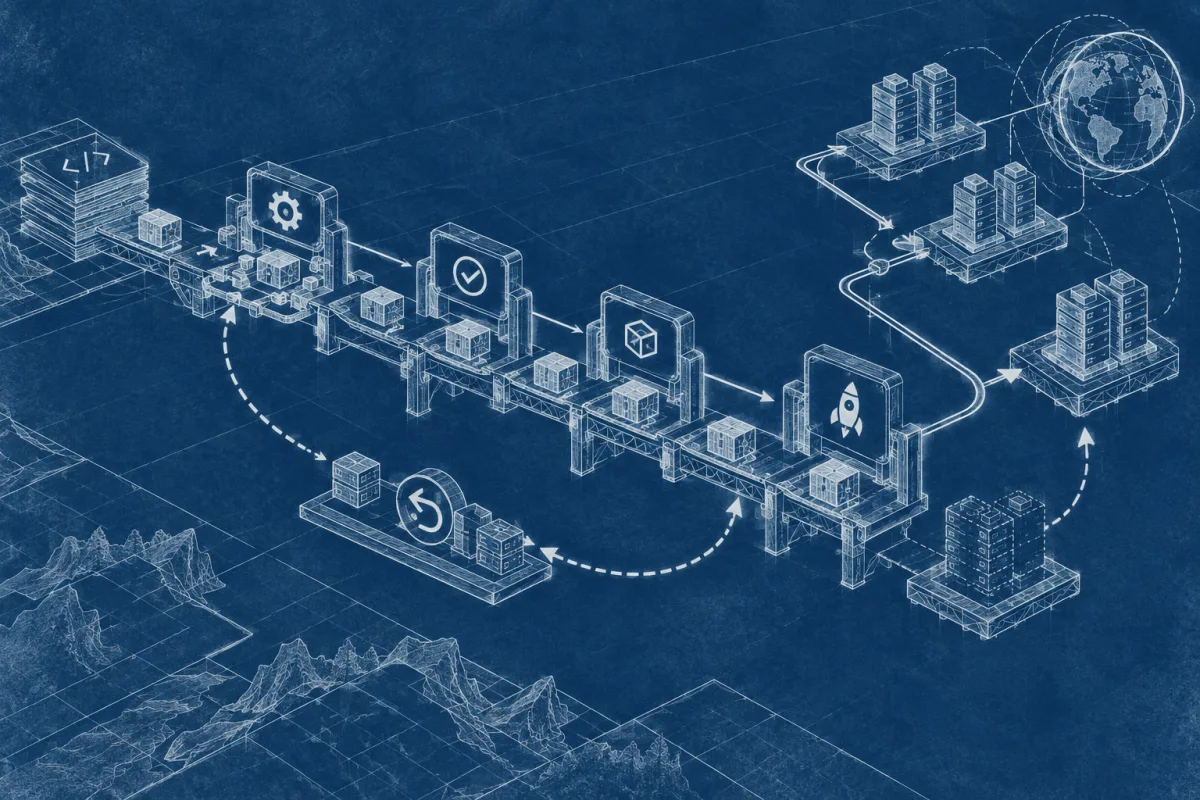
DevOps-инженер отвечает за путь, который код проходит от коммита до работающего сервиса, и за то, чтобы этот путь был быстрым, повторяемым и обратимым. Он не пишет бизнес-логику и не настраивает серверы вручную по чек-листу — он строит систему, где сборка, проверка, выкатка и откат происходят по описанным правилам, а не по памяти дежурного.
Сразу о главном ограничении: это не стартовая профессия. DevOps вырастает из двух соседних ремёсел — эксплуатации и разработки — и требует, чтобы одно из них вы уже понимали.
Из чего складывается работа
DevOps — сначала подход к организации работы, а уже потом должность: те, кто пишет код, и те, кто его эксплуатирует, отвечают за общий результат. Кто-то должен построить и поддерживать инструменты, благодаря которым это возможно, — так и появилась роль. Профильного инструмента, как Figma у дизайнера, здесь нет; есть четыре области, и в вакансиях они встречаются в разных сочетаниях.
Конвейер сборки и доставки
CI/CD — автоматическая цепочка: код попал в репозиторий, запустилась сборка, прогнались тесты и проверки безопасности, собрался артефакт, он выкатился на тестовый контур, потом на боевой. Инженер описывает цепочку в конфигурации (GitLab CI, Jenkins, GitHub Actions) и разбирается, почему она сломалась, — а ломается она чаще не из-за плохого кода, а из-за обновившейся зависимости или просроченного сертификата.
Инфраструктура как код
Серверы, сети, базы и права доступа описываются текстовыми файлами в репозитории рядом с кодом: Terraform задаёт, какие ресурсы должны существовать, Ansible — в каком состоянии должна быть система внутри них.
У подхода есть цена. Terraform хранит соответствие между описанием и реальными объектами в облаке в файле состояния, и документация HashiCorp предупреждает: при локальной работе состояние лежит в открытом виде и содержит все секретные значения из конфигурации (HashiCorp Developer). Поэтому его выносят в удалённое хранилище с шифрованием и блокировкой — иначе секреты окажутся в Git, а два инженера, применившие изменения одновременно, получат расходящуюся инфраструктуру.
Инструменты этого уровня осваивают отдельно и на реальных стендах. Курс по Ansible для DevOps-инженера от Skillbox рассчитан на два месяца, разбирает инвентарь, плейбуки, роли и хранение секретов в Ansible Vault, а итоговой работой делает плейбук с описанием отката — тот самый артефакт, который можно показать на собеседовании.
Контейнеры и оркестрация
Образ в терминологии Docker — «доступный только для чтения шаблон с инструкциями для создания контейнера», а контейнер — «работающий экземпляр образа» (документация Docker). Каждая инструкция Dockerfile создаёт отдельный слой, и при пересборке пересчитываются только изменившиеся слои. Когда контейнеров становится много, появляется Kubernetes, и полезно прочитать, что документация проекта пишет о его границах: Kubernetes «не разворачивает исходный код и не собирает ваше приложение» и «не диктует решения для логирования, мониторинга и оповещений» (kubernetes.io). Кластер не заменяет ни CI/CD, ни наблюдаемость — их придётся строить самому.
Наблюдаемость и дежурства
Метрики, логи и трассировки нужны, чтобы во время инцидента говорить не «кажется, всё легло», а «выросла задержка на этом сервисе после выкатки такой-то версии». Инженер настраивает сбор данных, пороги оповещений и панели, а затем сам отвечает на срабатывания по графику дежурств — в том числе ночью.
Учебный пример: как выглядит задача целиком
Ситуация вымышленная, но собрана из типовых. В интернет-магазине выкатка версии занимает два часа и делается вручную по документу на двенадцать шагов. Раз в несколько релизов кто-то путает порядок, магазин на пятнадцать минут отдаёт ошибку — поэтому релизят раз в две недели и поздно вечером.
Инженер начинает не с инструментов, а с измерения: сколько релизов в месяц, сколько из них потребовали срочного вмешательства, сколько занимает возврат к рабочему состоянию. Дальше он собирает приложение в контейнерный образ, описывает тестовый контур в Terraform и переносит двенадцать ручных шагов в пайплайн: сборка, тесты, публикация в реестр, выкатка на тест, подтверждение, выкатка на боевой. Новая версия поднимается рядом со старой, трафик переключается после проверки работоспособности, откат делается одной командой.
Результат измеряется не числом внедрённых инструментов: релиз занимает восемь минут, его делает сам разработчик в рабочее время, неудачная выкатка откатывается за минуту.
Чем измеряют результат этой работы
У профессии есть общепринятая измерительная рамка — метрики программы DORA. Их до сих пор называют «четырьмя ключевыми», хотя это уже неточно: на сайте программы сформулированы пять показателей в двух группах (dora.dev). Пропускную способность описывают частота развёртываний, время от коммита до продакшена и время восстановления после неудачного развёртывания; нестабильность — доли развёртываний, потребовавших срочного вмешательства и вызванных инцидентом.
Переименования здесь не косметические. В 2023 году метрику MTTR заменили на «время восстановления после неудачного развёртывания», потому что прежнее определение не различало сбой из-за изменения кода и сбой из-за внешней причины вроде аварии в дата-центре; в 2024-м добавили пятый показатель, чтобы измерять объём переделок напрямую (история метрик DORA). Разговор о метриках на собеседовании быстро показывает, понимаете ли вы, что именно меряется. Отчёт DORA за 2025 год, построенный на опросе около пяти тысяч специалистов, добавляет наблюдение, полезное и новичку: инструменты ИИ ускоряют доставку, но ухудшают её стабильность (Google Cloud).
Соседние роли: сисадмин, SRE, платформенный инженер
В вакансиях эти названия перемешаны, но различие влияет на ежедневные задачи.
| Роль | Предмет работы | Чем отличается |
|---|---|---|
| Системный администратор | Работающая инфраструктура и пользователи | Поддерживает существующее, изменения вносит вручную или скриптами |
| DevOps-инженер | Путь изменения от коммита до продакшена | Строит конвейер и описывает инфраструктуру кодом, отвечает за скорость и обратимость выкаток |
| SRE | Надёжность конкретного сервиса | Работает от доступности и бюджета ошибок, ведёт инциденты |
| Платформенный инженер | Внутренняя платформа для команд разработки | Делает продукт для внутренних пользователей: шаблоны и единые правила |
Разницу между DevOps и SRE яснее всего показывает правило из книги Google: там установлен «потолок в 50 % на совокупную операционную работу для всех SRE», остальное время инженеры обязаны тратить на разработку, снижающую количество ручных операций (sre.google). Оттуда же бюджет ошибок: при целевой доступности 99,9 % разрешённая недоступность — ресурс, который тратят на скорость выпуска. Вывод простой: читайте не название вакансии, а список задач.
Рутина, о которой редко предупреждают
Самая недооценённая часть работы — обновления, и здесь виден характер профессии: сроки диктует не менеджер, а жизненный цикл инструментов. Минорные релизы Kubernetes выходят примерно три раза в год (kubernetes.io), а каждая ветка поддерживается около четырнадцати месяцев: двенадцать месяцев обычной поддержки и два месяца режима обслуживания, когда выпускают только исправления уязвимостей с присвоенным CVE (политика патч-релизов). При этом политика совместимости версий запрещает перескакивать через минорные версии при обновлении kube-apiserver — даже в кластере с единственным управляющим узлом (version skew policy).
Сложите одно с другим. Кластер, который не трогали полтора года, нельзя обновить одним движением: придётся пройти три-четыре минорных релиза подряд, на каждом шаге проверяя, не удалили ли в нём API, которые использует ваше приложение. Инфраструктура, которую «настроили и забыли», через год превращается в проект на несколько недель — в вакансиях это зовётся «поддержкой и развитием инфраструктуры».
Что может не подойти
Дежурства — главный фильтр: ночной звонок из-за сбоя в чужом коде переносится тяжелее, чем кажется, и это регулярная нагрузка. Вторая особенность — работа в чужой зоне ответственности: вы влияете на то, как разработчики выкатывают код, но не отдаёте им приказов. Третья — результат невидим: хорошо сделанный конвейер замечают только в тот час, когда он не работал. И цена ошибки выше, чем в разработке: неверная строка в описании инфраструктуры способна удалить боевую базу.
Какая база нужна до старта
Честный минимум выглядит так.
- Linux на уровне уверенного пользователя командной строки: права, процессы, systemd, журналы, пакеты, диски, диагностика «почему сервис не поднялся».
- Сети: IP-адресация и маршрутизация, DNS, HTTP и HTTPS, сертификаты, прокси и балансировка.
- Один язык сценариев: Bash обязателен, плюс Python на уровне «скрипт, который ходит в API и разбирает JSON».
- Git не только как «закоммитить»: ветки, слияния, разрешение конфликтов, запросы на слияние.
- Опыт эксплуатации или разработки: год-два администрирования, поддержки или бэкенда.
Без этой базы в программу с Kubernetes на второй неделе идти рано. Комплексные программы вроде курса «Профессия DevOps-инженер» от Skillbox сознательно начинают с системного администрирования — Linux, серверы, сети, мониторинг, резервное копирование — и только затем переходят к Git, CI/CD, Docker, Ansible и Kubernetes; длительность 9–12 месяцев и более 400 часов практики показывают объём разгона.
Как показать первые результаты
Портфолио здесь — воспроизводимый стенд: репозиторий с описанием инфраструктуры небольшого приложения, пайплайн, который его собирает и выкатывает, мониторинг с осмысленными оповещениями и README с инструкцией, как развернуть всё с нуля и как откатить. Отдельно ценится разбор поломки: сломайте стенд намеренно — удалите узел, выкатите нерабочую версию, исчерпайте место на диске — и запишите, как обнаружили проблему и что изменили, чтобы она не повторилась. Такой текст показывает способ мышления, а список технологий — нет.
Сколько платят
По данным hh.ru, медиана предлагаемой в вакансиях зарплаты DevOps-инженеров в России в апреле 2026 года составила 223 950 рублей — один из самых высоких показателей среди всех профессий в выборке (CNews со ссылкой на исследование hh.ru). Две оговорки обязательны: это предложение работодателя в объявлении, а не фактическая выплата, и считали его по всем уровням сразу, тогда как вход в профессию происходит заметно ниже.
Сопоставимой публичной статистики по грейдам мало: «Хабр Карьера» показывает медианы по квалификациям, но полные значения открывает только участникам, которые сами сдали анкету. Надёжнее смотреть рынок самостоятельно. Задайте в поиске вакансий регион и опыт отдельно для «1–3 года» и «3–6 лет» — разрыв между фильтрами и есть цена опыта. Ориентируйтесь на медиану, а не на среднее: несколько окладов под полмиллиона сильно тянут среднее вверх. Проверяйте, указана сумма до вычета налога или на руки, и помните, что часть вакансий вилку не публикует. Прибавляют к доходу опыт с конкретным облаком, высоконагруженные системы и дежурства — за них в ряде компаний платят отдельно.
Как выбрать обучение и с чего начать
Первый шаг не требует денег: поднимите виртуальную машину с Linux, доведите до автоматизма права, службы, журналы и сеть, а затем упакуйте простое приложение в контейнер. Если это даётся мучительно, на курс по Kubernetes рано.
Выбирая платный курс, смотрите не на список технологий — он почти одинаковый у всех, — а на устройство практики: облачные стенды вместо скриншотов, проверка работ преподавателем, сквозной проект, который к концу превращается в репозиторий, разбор инцидентов. Уточняйте, входит ли стоимость облачных ресурсов в цену обучения.
Тем, у кого база уже есть, длинный разгон не нужен: курс «DevOps-инженер PRO» от Skillbox рассчитан на шесть месяцев и сразу заходит с инфраструктуры как кода, контейнеризации, GitLab CI и Jenkins — в описании прямо сказано, что он адресован опытным администраторам Linux, а не новичкам в IT.
Путь в профессию не один: чаще всего приходят из системного администрирования, добавляя к эксплуатации автоматизацию и код, реже — из бэкенд-разработки или тестирования. Первой должностью не обязательно станет «DevOps-инженер»: вакансии младшего администратора или инженера поддержки инфраструктуры дают ту практику, которой не хватает после курса.
Сравнить предложения разных платформ по стоимости, объёму практики и поддержке наставника помогает рейтинг онлайн-школ по DevOps и инфраструктуре на Учи.Онлайн — подборка по всему направлению, а не по одной должности, поэтому в ней соседствуют программы для новичков в администрировании и курсы по отдельным инструментам.
Прежде чем выбирать программу, проверьте себя тремя вопросами. Можете ли вы без подсказок разобраться, почему сервис на Linux не запускается? Готовы ли отвечать на оповещения ночью хотя бы неделю в месяц? Устраивает ли вас работа, которую замечают, только когда её не сделали? Три уверенных «да» — хороший знак. Сомнение хотя бы в одном — повод сначала потратить несколько месяцев на Linux и сети.