
RAG: как научить нейросеть отвечать по документам компании и проверять ответы
RAG (retrieval-augmented generation, генерация с опорой на найденные документы) — приём, при котором система перед ответом ищет в документах компании подходящие фрагменты и передаёт их языковой модели вместе с вопросом, а модель отвечает только по ним и называет источник. Чтобы собрать такую систему, нужно подготовить и разбить документы на фрагменты, превратить их в эмбеддинги, настроить поиск по смыслу и по словам, научить модель ссылаться на документ, отдельно проверять поиск и ответ и не дать системе показывать файлы тем, кому они не положены.
Содержание
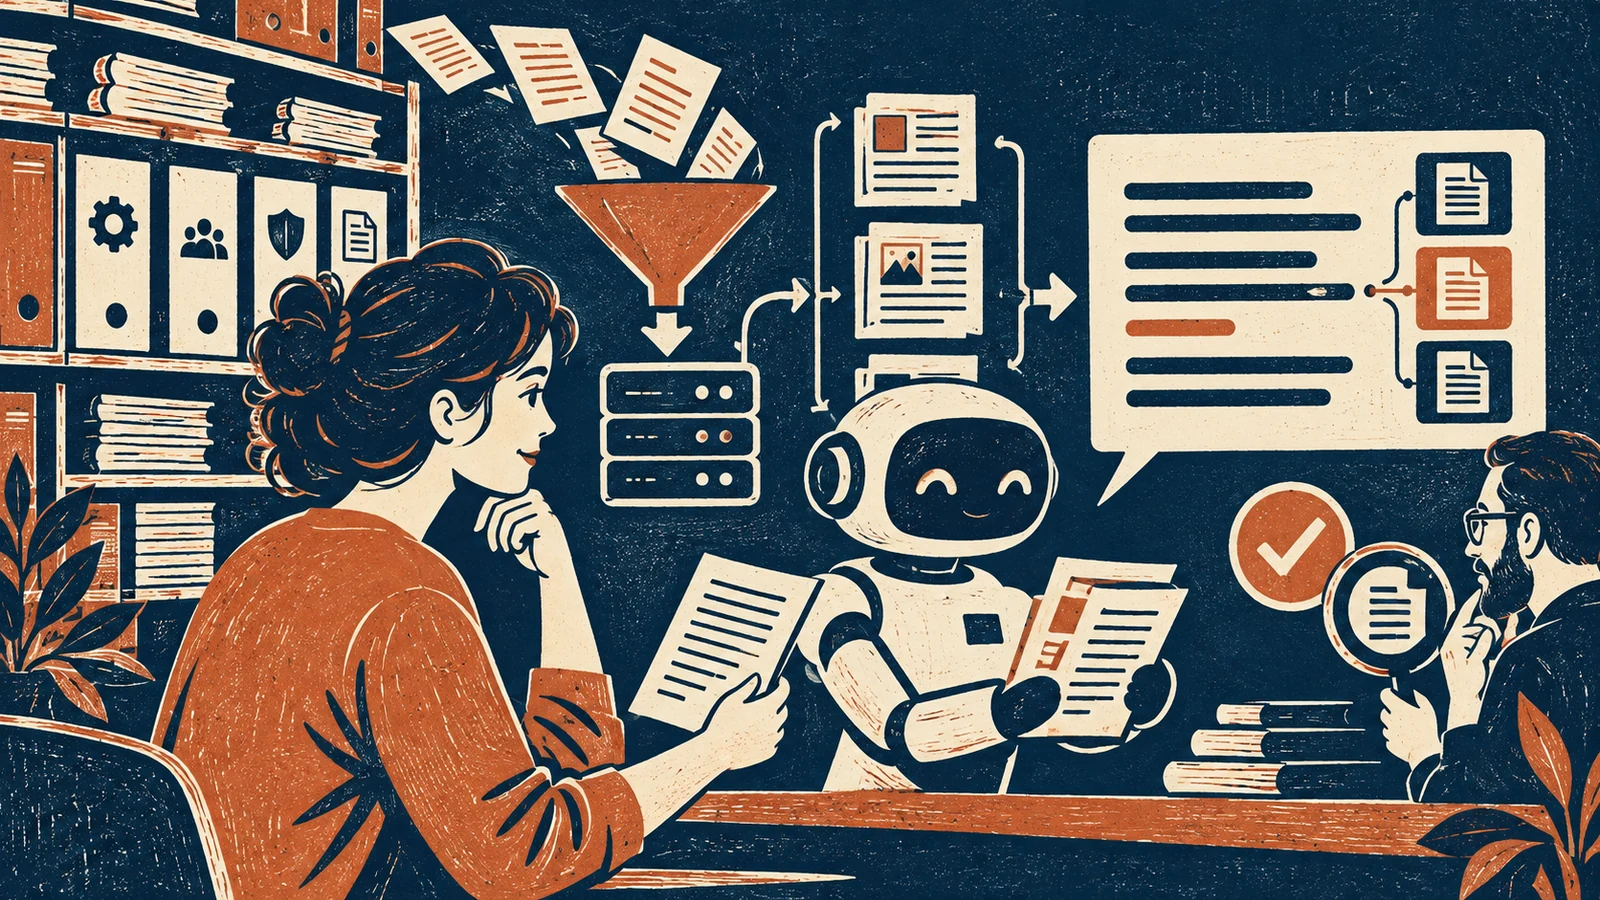
Частое заблуждение: «загрузили PDF в бота — и он всё знает». Модель видит только то, что принёс поиск: если нужный абзац не попал в выдачу, хорошего ответа не будет при любой модели, а плохой прозвучит уверенно. Поэтому работа с RAG почти всегда начинается с документов и поиска, а не с выбора нейросети.
Как устроен RAG и где он ломается
Работа делится на два этапа. Заранее из файлов извлекают текст, режут его на фрагменты, для каждого считают эмбеддинг и складывают в векторную базу с метаданными: документ, раздел, дата редакции, кому разрешён доступ. Во время вопроса система находит ближайшие к запросу фрагменты и собирает промпт: инструкция, фрагменты с номерами, вопрос.
Сломаться может каждое звено: скан без текстового слоя даёт пустой фрагмент, разрезанная таблица теряет заголовки столбцов, старая редакция регламента оказывается ближе к вопросу, чем новая. Модель при этом честно пересказывает то, что получила.
Когда RAG нужен, а когда нет
RAG оправдан, когда документов много, они меняются и ответ должен опираться на конкретный пункт. Если база маленькая, проще отдать её модели целиком. В материале Anthropic о contextual retrieval прямо сказано: базу знаний меньше 200 000 токенов, примерно 500 страниц, можно включить в промпт полностью, а кэширование промпта сделает это быстрее и дешевле.
Дообучение (fine-tuning) меняет стиль и формат ответа, но плохо подходит для фактов, которые обновляются каждый месяц: новый приказ проще положить в базу, чем переобучать модель. Для личных конспектов хватит готового сервиса вроде NotebookLM, о котором на сайте есть отдельная статья; собственный RAG нужен, когда важны права доступа и контроль качества.
Учебный пример: справочная по внутренним регламентам
Ситуация учебная. В IT-компании на 300 сотрудников вопросы об отпуске, командировках и VPN приходят в HR и техподдержку. База — 120 документов, среди них закрытое положение о грейдах, которое видит только HR.
Первая версия режет текст на куски по 500 токенов и ищет только по смыслу. На вопрос «сколько суточных в Казани» она приносит общий абзац о командировках: таблица норм разрезана, и строка «Казань» осталась без шапки. На вопрос про форму «АО-3» нужный шаблон не находится, потому что короткий код плохо передаётся эмбеддингом. А стажёр, спросивший о вилке грейда 5, получает цитату из закрытого положения.
Исправления идут в том же порядке. Таблицы режут по строкам с повтором заголовков, к каждому фрагменту добавляют название документа и раздела, поиск по смыслу дополняют поиском по словам. Фильтр прав ставят в сам запрос к базе: фрагменты, недоступные отделу сотрудника, вообще не попадают к модели.
Подготовка документов и разбиение на фрагменты
Подготовка — самая долгая часть работы: документы приводят к тексту, удаляют дубли и архивные редакции, сохраняют заголовки разделов. Резать удобнее по смысловым границам — разделу, пункту, строке таблицы. Слишком мелкий фрагмент теряет контекст, слишком крупный размывает эмбеддинг.
Проблему потерянного контекста Anthropic измерила в том же материале от 19 сентября 2024 года. К каждому фрагменту модель дописывала пояснение на 50–100 токенов: из какого документа фрагмент и о чём он. Метрикой была доля неудачных извлечений, то есть 1 минус recall@20: как часто нужный фрагмент не попадал в двадцать первых результатов. С пояснениями доля неудач упала с 5,7 до 3,7 % (на 35 %), с пояснениями и поиском по словам BM25 — до 2,9 % (на 49 %), а с реранкингом — до 1,9 % (на 67 %). Разовая подготовка таких пояснений, по расчёту авторов, стоила 1,02 доллара на миллион токенов документов. Цифры получены на наборах данных и моделях Anthropic, на своих документах их стоит перепроверить.
Эмбеддинги, гибридный поиск и реранкинг
Эмбеддинг — список чисел, в который модель превращает текст так, что близкие по смыслу фрагменты получают близкие числа; векторная база быстро находит ближайших соседей запроса. Индекс и вопросы обрабатывают одной моделью эмбеддингов, а при её замене пересчитывают всю базу.
Поиск по смыслу хорошо понимает перефразировки, но плохо справляется с кодами, артикулами, фамилиями и номерами пунктов. Эту часть берёт на себя поиск по словам (BM25), и гибридный поиск объединяет обе выдачи. Реранкер — отдельная модель, которая читает вопрос вместе с каждым кандидатом и пересчитывает релевантность. В эксперименте Anthropic первичный поиск брал 150 фрагментов, а после реранкинга в промпт уходили 20 лучших.
Ссылка на источник в ответе
По ссылке человек проверяет ответ, а вы — работу системы. Фрагменты передают модели с номерами и просят отвечать только по ним, ставить номер после каждого утверждения и прямо говорить, если ответа в документах нет. В интерфейсе номер превращают в название документа и раздела.
Сама ссылка ещё ничего не доказывает. Модель может поставить номер к фразе, которой в этом фрагменте нет, поэтому при проверке сверяют утверждение с цитатой, а не только наличие ссылки.
Как проверять качество: поиск отдельно, ответ отдельно
Оценку делят на две части, иначе непонятно, что чинить. Для поиска к каждому вопросу набора указывают фрагмент с ответом и считают, как часто он попадает в первые k результатов. Для ответа проверяют верность источнику (faithfulness): подтверждается ли каждое утверждение переданными фрагментами — и отказывается ли система, когда ответа в базе нет.
Авторы библиотеки Ragas предлагают оценивать релевантность найденных фрагментов, верность их использования и качество ответа автоматически, без ручной эталонной разметки. Но оценщиком служит языковая модель, а она тоже ошибается, поэтому часть ответов выборочно читает человек.
Права доступа и утечки
Векторная база — такое же хранилище данных, как файловый сервер. В пункте OWASP LLM08:2025 Vector and Embedding Weaknesses названы утечки из-за неверных прав, утечки между группами пользователей общей базы, восстановление значительной части текста по эмбеддингам и отравление данных: например, кандидат прячет в резюме белый текст с просьбой рекомендовать его.
Отсюда правила. Права проверяют при поиске, по метаданным фрагмента, а не просьбой к модели «не показывай секретное». Разные отделы получают раздельные коллекции или жёсткий фильтр, удалённый документ убирают и из индекса, текст очищают от скрытого форматирования, запросы пишут в журнал.
С чего начать и в каком порядке осваивать
Порядок выстроен так, чтобы каждый следующий шаг можно было проверить цифрами предыдущего. Если сразу собрать гибридный поиск с реранкером, вы не узнаете, что дало пользу, а что только усложнило систему.
- Возьмите 20–30 открытых документов, например правила какого-нибудь сервиса, и составьте 40 вопросов с указанием фрагмента, где лежит ответ.
- Соберите простой поиск по смыслу и посчитайте, как часто нужный фрагмент попадает в первые пять результатов.
- Меняйте по одному параметру: размер фрагментов, разбиение по разделам, пояснение — и прогоняйте тот же набор.
- Добавьте поиск по словам и реранкер и сравните с прежним результатом.
- Подключите модель, попросите ссылки на номера фрагментов и вручную проверьте 20 ответов на верность источнику.
- Разметьте документы по уровням доступа и убедитесь, что пользователь без прав не получает закрытых фрагментов ни при каком вопросе.
Новички чаще всего ошибаются одинаково: проверяют систему на тех же вопросах, на которых её настраивали, меняют несколько параметров сразу, оценивают только итоговый ответ и не смотрят выдачу поиска, а права доступа доверяют инструкции для модели.
Где учиться
Начать с бесплатного материала можно на онлайн-курсе Слёрма «ИИ для инженеров: польза и риски»: шесть онлайн-занятий за три недели, после каждого — файл с заданием. Для темы RAG важны два: автоматическое исправление проблем продакшена с RAG и языковые модели для центра мониторинга безопасности, где RAG используют вместо дообучения. Подготовку документов и метрики поиска описание не называет, а даты старта на странице противоречат друг другу — уточните их у школы.
Лекции показывают, где RAG применяют инженеры, но навык появляется только на своих документах и своём тестовом наборе, поэтому ищите практику с проверкой.
Тем, кто хочет собрать RAG без программирования, подойдёт онлайн-курс Яндекс Практикума «ИИ-агенты и автоматизация». За шесть или восемь недель, в зависимости от тарифа, собирают процессы в n8n с векторными базами, RAG и защитой от промпт-инъекций. Писать код не нужно, но разбираться в API, данных и правах доступа придётся. Цена — 64 000 ₽; для какого тарифа она действует, нужно уточнить у школы.
Руководителю поддержки, который ставит задачу разработчикам и принимает результат, важнее качество исходной базы и правила о том, какие данные можно передавать сервису.
Для этой роли есть онлайн-курс Эдюсона «Нейросети для клиентского сервиса»: два месяца, 37 часов, 44 урока, куратор и домашние работы. В программе модули о базе знаний и безопасности данных, среди практических работ — настройка ответов по документам и техническое задание на бота. Термин RAG в описании не встречается, поиск подробно не разбирают. Цена — 50 000 ₽, условия рассрочки уточните у школы.
Как навык влияет на доход
Отдельной строкой RAG в зарплате не появляется: навык входит в требования к бэкенд-разработчику, LLM-инженеру (о нём на сайте есть отдельная статья) или специалисту по внедрению ИИ. Открытых данных о надбавке именно за RAG с описанной методикой найти не удалось.
Влияние косвенное: кто умеет собрать поиск, измерить его и закрыть доступ к лишнему, берёт задачу целиком. Чтобы оценить рынок, ищите вакансии на hh.ru и Хабр Карьере с RAG и векторными базами, фильтруйте по региону и опыту, сравнивайте медианы и уточняйте, указана сумма до вычета налога или на руки.
Как выбрать обучение
Перед оплатой спросите, на каких документах идёт практика, учат ли составлять тестовый набор и считать качество поиска, разбирают ли гибридный поиск и права доступа и оплачиваются ли модели отдельно. Один урок о RAG на готовом конструкторе даст представление, но не научит искать причину ошибок.
Сравнить школы поможет рейтинг онлайн-школ с обучением ИИ для разработчиков — он шире темы RAG и охватывает всё направление. Если ваша учебная справочная находит нужный фрагмент в большинстве вопросов тестового набора, ставит проверяемые ссылки и не показывает закрытые документы, основу вы освоили и можно переходить к документам своей команды.