
Временные ряды для аналитика: тренд, сезонность, прогноз спроса и проверка модели
Анализ временных рядов — это работа с показателем, который измеряют через равные промежутки: продажи по дням, обращения в поддержку по часам, выручка по месяцам. Аналитик выравнивает шаг и заполняет пропуски, раскладывает ряд на тренд, сезонность и остаток, проверяет стационарность и автокорреляцию, строит простые эталонные прогнозы, затем ETS, ARIMA, Prophet или градиентный бустинг на лагах и сравнивает их на отложенном отрезке будущего по MAE, MAPE или MASE. Для работы хватает Python с pandas и statsmodels. Самое сложное здесь — честная проверка, а не выбор модели.
Содержание
Типичная ошибка новичка — разделить строки на обучение и проверку случайно, как в обычной задаче машинного обучения. Модель «подглядывает» в соседние дни, ошибка на проверке выходит маленькой, а на следующей неделе прогноз разваливается. Второе заблуждение — что сложная модель точнее. Любую модель сначала сравнивают с правилом «будет как в тот же день неделю назад», и обойти его удаётся не так часто, как кажется.
Где нужен анализ рядов, а где другой инструмент
Навык нужен там, где решение зависит от того, что будет через неделю или квартал. Закупщик заказывает товар с учётом сезона, руководитель колл-центра планирует смены, финансист прогнозирует выручку для бюджета, инженер следит за нагрузкой на серверы. Везде важен порядок наблюдений: вчерашнее значение говорит о сегодняшнем, а одна и та же неделя года повторяется.
Другой инструмент нужен, когда вопрос о причине: поднял ли продажи новый баннер, покажет эксперимент, а не прогноз. Если истории меньше двух полных сезонов, годовую сезонность не оценить, и честнее работать со сценариями. Редкие продажи по одной штуке в месяц классические модели прогнозируют плохо, для них есть отдельные методы. Основы моделей и статистики разбирают наши статьи о машинном обучении и статистике.
Из чего складывается ряд
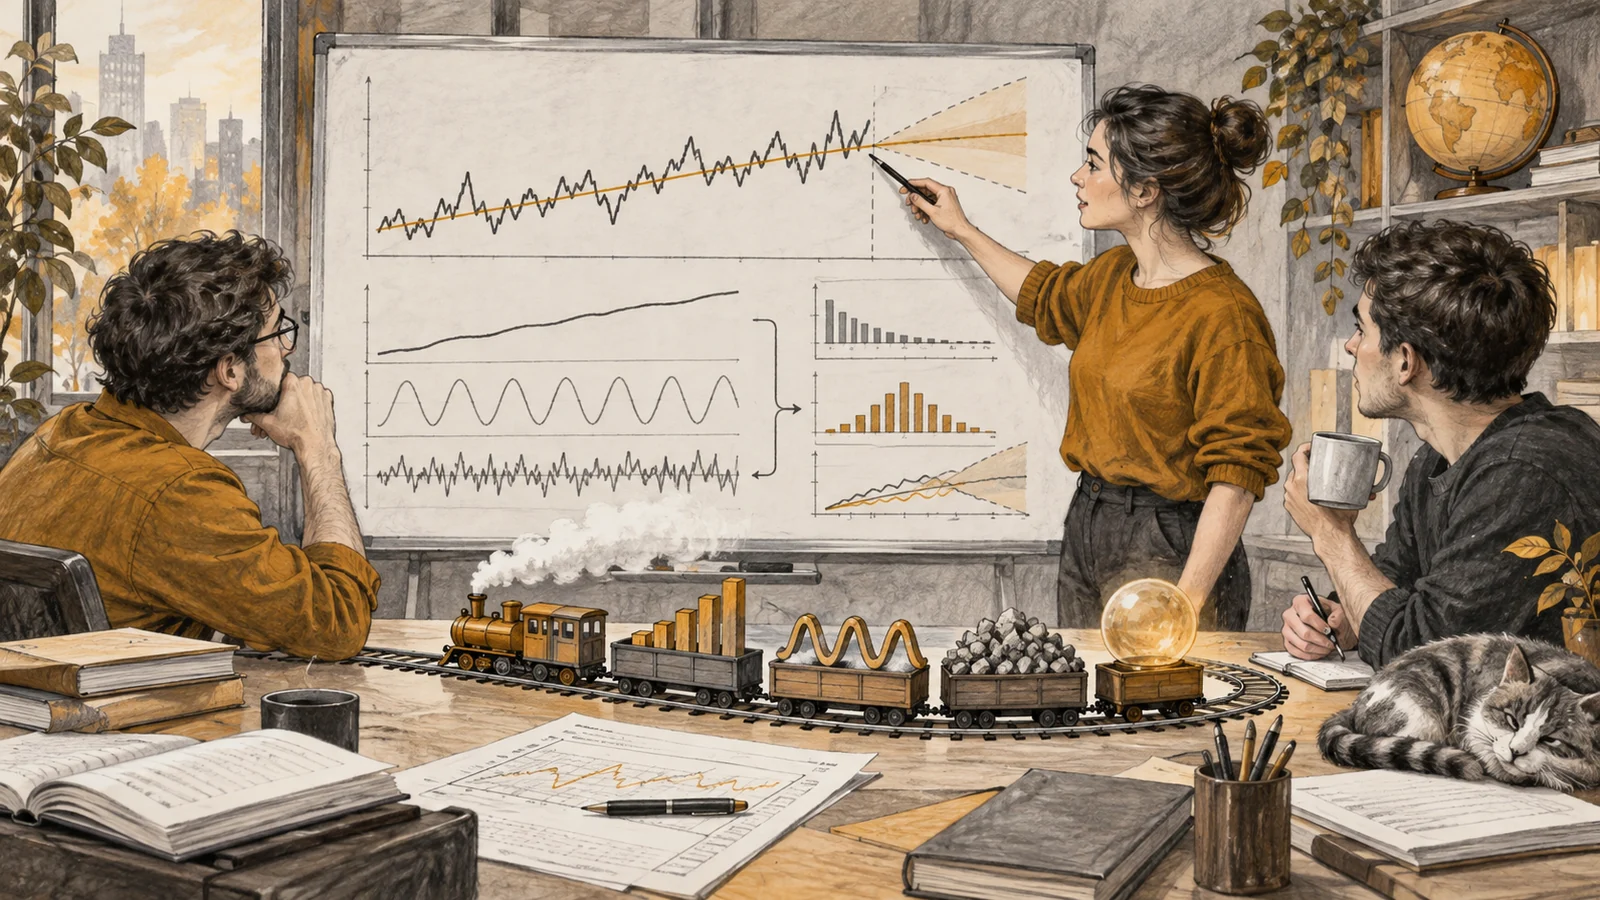
Тренд — медленное изменение уровня: клиентов больше, и обращений больше. Сезонность — рисунок с известным периодом: понедельник тяжелее субботы, декабрь сильнее февраля. У дневных данных часто две сезонности, недельная и годовая, а сверху — праздники и переносы рабочих дней. Остаток — то, что не объясняют ни тренд, ни сезон. Разложение методом STL из statsmodels показывает три части на одном графике; если сезонная волна растёт вместе с уровнем, ряд логарифмируют или берут мультипликативную модель.
Стационарность — это когда среднее и разброс ряда не меняются со временем. ARIMA требует стационарного ряда, поэтому тренд убирают разностями: вместо продаж берут их изменение к прошлому дню или к тому же дню прошлой недели. Проверяют двумя тестами с противоположными гипотезами: в тесте Дики — Фуллера нулевая гипотеза — ряд нестационарен, в KPSS — стационарен. Если тесты спорят, смотрят на график и пробуют разность.
Автокорреляция показывает сходство ряда с самим собой со сдвигом. На дневных продажах её график обычно даёт пики на лагах 7, 14, 21 — это недельная сезонность. По нему подбирают порядки ARIMA и лаги для бустинга.
Учебный пример: прогноз обращений в колл-центр
Ситуация учебная. У сервиса три года ежедневных обращений в поддержку, руководителю нужен прогноз на восемь недель вперёд для графика смен. Аналитик начинает с данных: приводит даты к одному часовому поясу, ищет пропущенные дни и отмечает дни сбоев, когда обращений было втрое больше обычного. Их не удаляют, а помечают признаком, иначе модель примет всплеск за часть сезона.
Затем строится схема проверки. Одного отложенного отрезка мало: неудачные недели дадут случайный результат. Поэтому берут скользящее начало прогноза: обучают модель на данных до даты отсечки, прогнозируют восемь недель, сдвигают отсечку на месяц и повторяют. В scikit-learn так делит данные TimeSeriesSplit — проверка всегда идёт после обучения.
Первым считают эталон — сезонный наивный прогноз, где каждый будущий день равен тому же дню недели в последнюю известную неделю. Потом модели. ETS, экспоненциальное сглаживание, обновляет уровень, тренд и сезонные поправки, придавая свежим наблюдениям больший вес. ARIMA описывает ряд через его прошлые значения и ошибки после взятия разностей. Prophet складывает кусочно-линейный тренд, сезонности и праздники, которые задаются простой таблицей. Градиентный бустинг, например LightGBM или CatBoost, получает признаки: значения с лагами, скользящие средние, день недели, праздник.
С бустингом легко устроить утечку через лаги. При горизонте 56 дней значение «вчера» для 56-го дня неизвестно. Лаги сдвигают не меньше чем на горизонт, либо модель прогнозирует по дню и подставляет свои прогнозы как лаги. Скользящее среднее считают только по прошлому.
С Prophet здесь есть неочевидная ловушка. По официальной документации Prophet модель по умолчанию расставляет 25 возможных точек излома тренда только по первым 80 % истории, чтобы не подстраиваться под колебания в конце ряда. На трёх годах дневных данных это примерно последние 219 дней, где тренд сломаться не может. Если полгода назад сервис запустил новый тариф и обращений стало больше, Prophet продлит старый наклон, и прогноз окажется ниже факта. Границу сдвигает параметр changepoint_range, например до 0,9, а гибкость тренда задаёт changepoint_prior_scale, по умолчанию 0,05. Какой вариант лучше, решает проверка на нескольких отсечках, а не вид графика.
Метрики и их подводные камни
MAE, средняя абсолютная ошибка, измеряется в единицах ряда: «в среднем ошибаемся на 40 обращений в день». Её легко объяснить руководителю, но нельзя сравнивать между рядами разного масштаба. Поэтому популярна MAPE, средняя абсолютная ошибка в процентах, и тут начинаются проблемы.
В учебнике Хиндмана и Атанасопулоса «Forecasting: Principles and Practice» в разделе 5.8 перечислены слабые места процентных ошибок. Они бесконечны или не определены при нулевом факте, а у штучного товара нулевые дни обычны. Они требуют шкалы с осмысленным нулём, поэтому для температуры в градусах Цельсия не годятся. И они по-разному штрафуют завышение и занижение. «Симметричная» sMAPE может быть отрицательной, а Хиндман и Кёлер в статье 2006 года рекомендовали её не использовать. Учебник предлагает MASE: ошибку делят на среднюю ошибку наивного прогноза на обучающих данных, для сезонных рядов — сезонного наивного. Значение меньше единицы значит, что модель лучше эталона.
Метрику выбирают под решение. Для графика смен важно не пропустить пики, поэтому отдельно смотрят ошибку в самые загруженные дни. Для закупки дорогого товара занижение дешевле завышения, и это учитывают до выбора модели.
Порядок освоения и упражнения
Каждый шаг опирается на предыдущий. Пока ряд не очищен, разложение покажет мусор; без эталона и схемы проверки не понять, помогла ли модель; бустинг идёт последним, потому что требует уверенной работы с лагами.
- Даты в pandas: индекс по времени, resample к дням и неделям, поиск пропусков и дублей.
- Графики и разложение: линия ряда, сезонный рисунок по дням недели, STL.
- Стационарность и автокорреляция: разности, тесты ADF и KPSS, графики ACF и PACF.
- Эталоны и проверка: наивный и сезонный наивный прогноз, скользящее начало, MAE и MASE.
- Классические модели: ETS и ARIMA в statsmodels, подбор параметров на обучающей части.
- Prophet: праздники, точки излома тренда, сравнение с ETS на тех же отсечках.
- Бустинг на лагах: признаки со сдвигом не меньше горизонта, сравнение с лучшей классической моделью.
Для тренировки подойдут открытые ряды: поездки городского проката велосипедов, почасовое потребление электроэнергии, продажи Walmart из соревнования M5. Полезное упражнение — обучить модель при случайном и при временном разбиении и сравнить ошибки: разница покажет цену утечки. Второе — посчитать MAPE на ряде с нулями.
Проверяйте себя: обходит ли модель сезонный наивный прогноз на нескольких отсечках, знали бы вы каждый признак в момент прогноза и объясните ли ошибку руководителю в штуках, звонках или рублях.
Когда нужен курс и что в нём проверить
Весь план выше можно пройти самостоятельно, но на рабочих данных возникают вопросы, где нужен разбор: почему модель хороша на одной отсечке и плоха на другой, как учесть акцию, о которой узнали за неделю. В описании программы ищите не слова «временные ряды», а конкретику: эталонные прогнозы, валидацию во времени, метрики масштаба.
На курсе TeachMeSkills «Data Scientist» временные ряды идут одним блоком с обработкой текстов после классического и глубокого обучения. Программа рассчитана на 7,5 месяца и 240 академических часов, два вечера в неделю, в конце — дипломный проект. Методы для рядов на карточке не перечислены, уточните их у школы.
Короткий блок даёт обзор, а честную проверку учатся строить на нескольких проектах с разными данными, где ошибку разбирает преподаватель. Поэтому смотрите, сколько проектов в программе и кто их проверяет.
На курсе Skillbox «Machine Learning Engineer + ИИ» 12 месяцев и больше десяти итоговых проектов, в том числе на Kaggle и на данных партнёра. Временные ряды названы среди моделей, а в описании отмечено, что для них нужны отдельные методы, поскольку случайное разбиение даёт слишком оптимистичный результат. Подробного плана по рядам на странице нет — запросите его у школы.
Если нужен диплом и есть время на двухлетнюю учёбу, подойдёт магистратура. Оцените нагрузку заранее: занятия идут вечерами по будням и по субботам.
Онлайн-магистратура Karpov.Courses «Аналитика больших данных» длится два года по 20–30 часов в неделю, диплом магистра выдаёт НИУ ВШЭ. В третьем семестре есть дисциплина «Анализ временных рядов на финансовых данных», в четвёртом — ML для фондового рынка. Если вам нужны продажи или нагрузка, методы придётся переносить самостоятельно.
Как навык влияет на доход
Статистики по надбавке за анализ рядов нет: исследования считают специализации, а не навыки. Для ориентира — данные Хабр Карьеры за первое полугодие 2026 года, опубликованные 21 июля 2026 года: по 45 226 зарплатам из калькулятора сервиса медиана аналитиков в IT составила 220 000 ₽ в Москве, 180 000 ₽ в Санкт-Петербурге и 160 000 ₽ в других регионах. Это фактические зарплаты всех уровней и всех типов аналитиков, а не только тех, кто прогнозирует.
На доход навык влияет через задачи: аналитик, который строит прогноз и доказывает, что он лучше наивного, берёт планирование закупок, персонала и бюджета. Чтобы оценить рынок, ищите на hh.ru вакансии со словами «прогнозирование» и «временные ряды», фильтруйте по региону и опыту и отличайте сумму на руки от суммы до вычета налога.
Что сделать дальше
Возьмите один рабочий ряд и постройте для него сезонный наивный прогноз с проверкой на трёх отсечках — это уже главное умение. Если захочется системы и обратной связи, сравнить школы поможет широкий рейтинг онлайн-школ с обучением Data Science: в нём программы по профессии целиком, поэтому блок о временных рядах в каждой сверяйте с учебным планом.