
Хранилище данных (DWH): слои, витрины и ETL — что нужно знать аналитику и инженеру данных
Хранилище данных (DWH, data warehouse) — отдельная аналитическая база, куда по расписанию загружают данные из CRM, кассы, сайта и учётной системы. Инженер копирует их в слой staging, сводит к общим ключам и единым правилам в ядре (core) и собирает витрины — таблицы под конкретные отчёты. Аналитик читает витрины и формулирует, какие из них нужны. Навык проектирования хранилища складывается из четырёх умений: выбрать модель ядра, объявить гранулярность таблицы фактов, настроить загрузку, которая не теряет и не дублирует строки, и поставить проверки на каждый слой.
Содержание
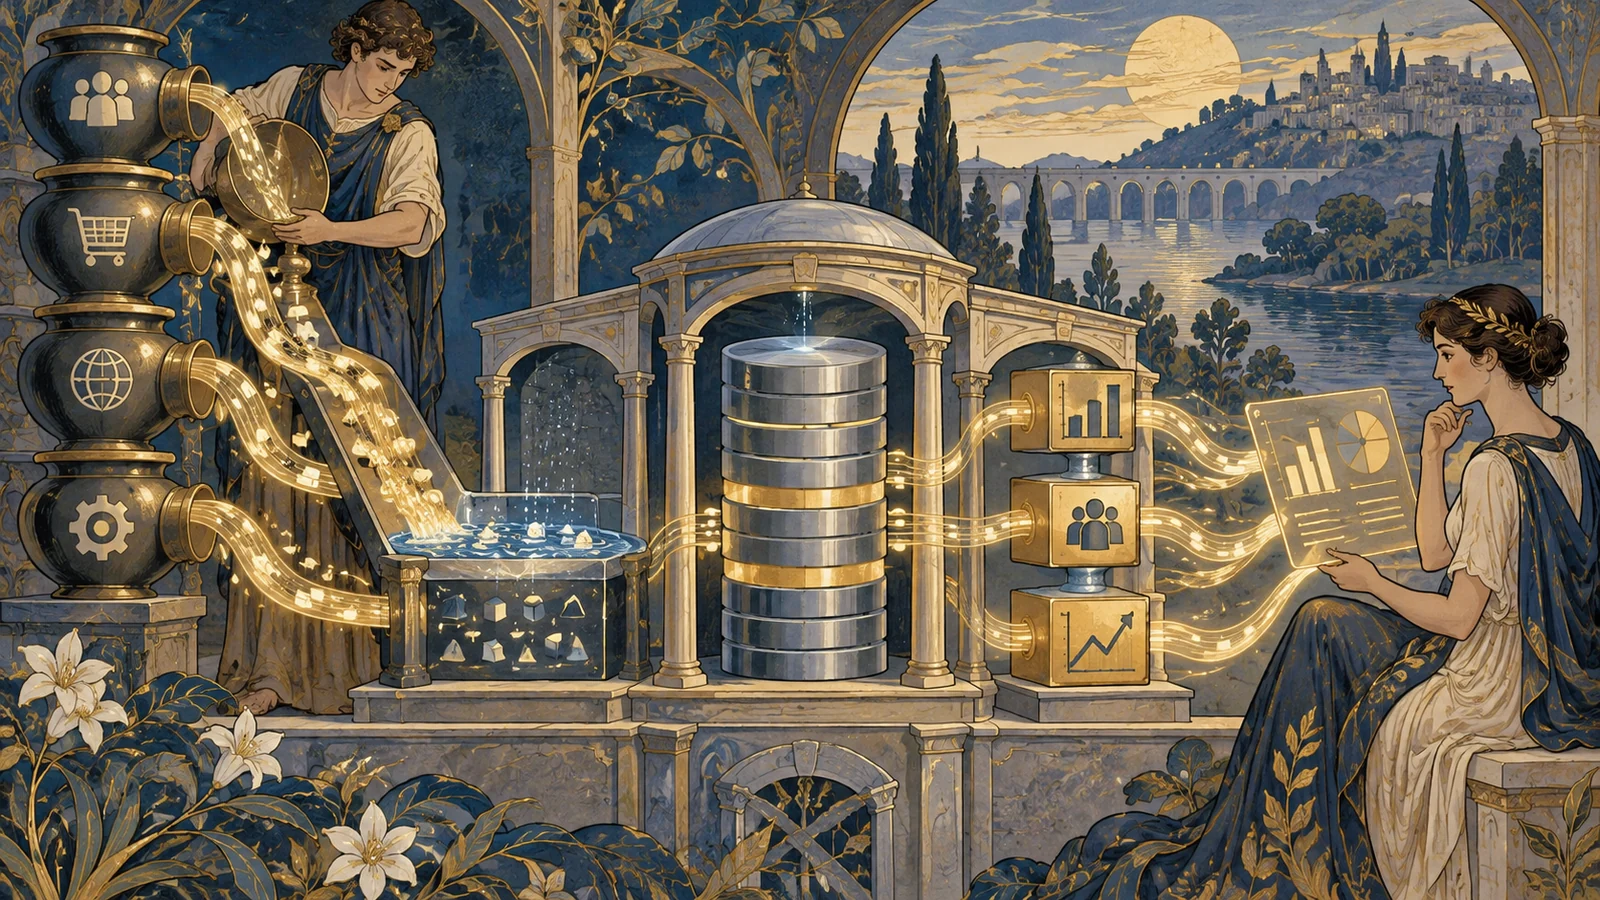
Хранилище — прежде всего набор договорённостей, а не конкретная СУБД: его собирают и в PostgreSQL, и в ClickHouse, и в Greenplum. Первая задача проектировщика обычно не техническая. В CRM «клиент» — карточка с телефоном, в кассе — номер бонусной карты, в бухгалтерии — договор. Пока они не связаны одним ключом, отчёт «выручка на клиента» зависит от того, кто и из какой системы его считал.
Три слоя и зачем их разделять
Слой staging хранит копии исходных таблиц почти без изменений: те же столбцы плюс время загрузки и имя источника. Его задача — отделить чтение из рабочих систем от всей дальнейшей логики. Если правило расчёта поменялось, ядро пересобирают из staging, не нагружая повторно кассу или CRM.
В ядре данные приводят к единой модели: устраняют дубли, переводят коды в справочники, связывают записи разных систем и хранят детальную историю. Витрины строят поверх ядра под конкретного потребителя — финансовый отчёт, дашборд продаж, выгрузку для модели. Витрина может быть денормализованной: её читают, а не правят.
При ETL («извлечь — преобразовать — загрузить») данные преобразуют до загрузки, на отдельном сервере. Всё чаще используют ELT: данные грузят как есть и преобразуют уже в хранилище SQL-запросами. Колоночным СУБД это подходит: они быстро читают нужные столбцы и считают агрегаты, на которых держатся витрины.
Кимбалл или Data Vault: как выбирают модель ядра
Подход Ральфа Кимбалла строит ядро из таблиц фактов (события и числа: продажа, визит, платёж) и измерений (кто, где, когда, что). Kimball Group описывает проектирование как четыре шага: выбрать бизнес-процесс, объявить гранулярность, определить измерения, определить факты. Порядок важен: гранулярность (что именно описывает одна строка факта) объявляют раньше, чем список столбцов, иначе в одну таблицу попадают события разного уровня.
Data Vault раскладывает ядро на три типа таблиц. Хабы хранят бизнес-ключи (номер клиента, артикул), линки — связи между ними, сателлиты — описательные атрибуты с историей изменений. Новый источник добавляют новыми сателлитами и линками, не перестраивая существующие таблицы, поэтому модель выбирают там, где источников десятки и они часто меняются. Цена — запросы с большим числом соединений, так что поверх Data Vault почти всегда строят витрины в виде «звезды». Кимбалл удобнее, когда источников немного и аналитики читают ядро напрямую.
Учебный пример: сеть фитнес-клубов
Ситуация условная. У сети из пяти клубов три системы: CRM с клиентами и абонементами, турникеты, которые пишут каждый проход, и касса с платежами. Руководство хочет видеть по месяцам выручку по клубам и долю абонементов, по которым был хотя бы один визит.
Источники копируют в staging и объявляют гранулярность: строка факта визитов — один проход через турникет, строка факта платежей — одна строка чека. Собрать визиты и платежи в одну таблицу нельзя: если клиент заплатил раз и пришёл двенадцать раз, при соединении платёж размножится, и выручка вырастет в двенадцать раз. Измерения у фактов общие — клиент, клуб, дата, тариф, — поэтому оба отчёта режут данные одинаково.
Турникет пишет номер карты, а в CRM у части клиентов карта не привязана. Такие проходы связывают со строкой измерения «клиент не определён», иначе внутреннее соединение выбросит их из отчёта и посещаемость окажется заниженной. Витрина «месяц — клуб — выручка — доля активных абонементов» собирается из готовых фактов одним запросом.
Инкрементальная загрузка и где она ломается молча
Перегружать всю таблицу каждую ночь просто, но с ростом объёма долго и дорого. Инкрементальная загрузка дописывает только новые и изменённые строки; в dbt, инструменте для ELT-преобразований на SQL, это материализация incremental.
У такой загрузки есть поведение по умолчанию, которое застаёт врасплох. В документации dbt сказано, что параметр on_schema_change по умолчанию равен ignore: если добавить столбец в инкрементальную модель и выполнить dbt run, столбец в целевой таблице не появится, а если удалить столбец, запуск упадёт. Ни один из режимов не заполняет новый столбец для старых строк — для этого нужен ручной UPDATE или полная пересборка с флагом --full-refresh, которая удаляет таблицу и строит её заново за всю историю.
На практике это выглядит так: аналитик добавил в модель визитов поле «промокод», запуск прошёл без ошибок, а в витрине поля нет. Защита простая: для важных моделей ставить on_schema_change=’fail’, чтобы расхождение схемы останавливало загрузку, а после изменения логики планировать полную пересборку модели и всех зависимых от неё.
Проверки качества на каждом слое
Проверки привязывают к слоям: на каждом ломается своё. В staging смотрят свежесть и объём: пришла ли выгрузка за вчера и не упало ли число строк вдвое против обычного. В ядре проверяют уникальность ключа в каждой таблице и ссылочную целостность: каждому ключу клиента в факте должна найтись строка в измерении. На уровне витрины сверяют итог с внешним источником — сумма выручки за месяц должна совпасть с отчётом кассы с допустимым расхождением.
Проверку пишут как SQL-запрос, который возвращает «плохие» строки: пустой результат означает успех. Заранее договоритесь, что делать при провале — останавливать витрину или публиковать её с предупреждением.
Lakehouse коротко
Lakehouse соединяет озеро данных и хранилище: файлы лежат в объектном хранилище, а табличный формат вроде Apache Iceberg или Delta Lake добавляет поверх них схему, транзакции и версии. Слои и модели при этом остаются теми же, меняется место хранения. Начинать с lakehouse не стоит: без понимания обычного хранилища его преимущества трудно оценить.
С чего начать и в каком порядке осваивать
Модель хранилища невозможно проверить, если вы не можете быстро написать запрос к ней, а загрузку бессмысленно автоматизировать, пока модель меняется каждый день. Каждый шаг даёт результат, который можно показать.
- Подтяните SQL: соединения, оконные функции, агрегаты с группировкой по нескольким измерениям.
- Установите PostgreSQL или DuckDB и загрузите открытый набор данных, где есть несколько связанных таблиц, — например учебную базу интернет-магазина.
- Нарисуйте на бумаге «звезду» по четырём шагам Кимбалла и запишите гранулярность каждой таблицы фактов одной фразой.
- Соберите в бесплатном dbt Core три слоя: staging, ядро, одну витрину.
- Переведите таблицу фактов на инкрементальную загрузку, добавьте тесты и запустите загрузку дважды за один день, чтобы убедиться, что дублей нет.
- Только после этого переходите к колоночной СУБД и оркестратору.
Упражнения и типичные ошибки
Спроектируйте ядро одной предметной области дважды, по Кимбаллу и в Data Vault, и напишите к обоим один запрос для витрины: станет видно, сколько соединений стоит гибкость. Затем намеренно сломайте данные — удалите строку измерения, задвойте загрузку — и посмотрите, какой тест это поймает.
Новички чаще всего смешивают в одном факте события разной гранулярности, строят витрины прямо из staging (и через полгода в пяти витринах живут пять определений «активного клиента») и проверяют лишь то, что загрузка завершилась. Результат проверен, если итог витрины сходится с источником за несколько периодов, а повторный запуск загрузки ничего не меняет.
Чему учат на программах Karpov.Courses и что проверить
Скажем прямо: все три программы ниже — одной школы, Karpov.Courses. Они разные по формату и уровню, но моделирование хранилища в опубликованных описаниях раскрыто скупо, так что состав тем уточните у школы до оплаты.
Тем, кто начинает с нуля и хочет прийти в инженерию данных, подойдёт курс Karpov.Courses «Инженер данных с нуля». По обзору на Учи.Онлайн, программа рассчитана на 6,5 месяца при нагрузке от 15 часов в неделю. Модуль «Хранилище данных» короткий — неделя и три урока, зато финальный проект — сквозной ETL-процесс от озера данных до аналитического хранилища. Кимбалл, Data Vault и dbt на странице не названы.
Действующему аналитику такой путь избыточен: ему важнее ставить задачу инженерам и проверять готовые витрины.
Для таких аналитиков рассчитан курс Karpov.Courses «Продвинутая аналитика данных». По обзору на Учи.Онлайн, на входе ждут Python, SQL и опыт с дашбордами; из четырёх модулей хранилищам посвящён второй — «Работа с командой хранилищ данных и обработка больших данных», пять недель с финальным проектом. Почти половина программы — эксперименты, хранилище здесь одна из тем.
При выборе любой программы спросите школу, проектируют ли студенты модель сами, есть ли инкрементальная загрузка и проверки качества и на какой СУБД идёт практика.
Тем, у кого есть высшее образование и кто готов учиться два года, подходит онлайн-магистратура Karpov.Courses и НИУ ВШЭ «Аналитика больших данных». По обзору на Учи.Онлайн, это четыре семестра при нагрузке 20–30 часов в неделю и стоимости 310 000 ₽; хранилищам отведена часть третьего семестра («основы инженерии данных, хранилища и обработка больших данных»). На странице сказано, что приём завершён и даты нового набора не определены.
Как навык влияет на доход
Отдельной профессии «специалист по DWH» в вакансиях почти нет: проектирование хранилища входит в требования к инженерам данных, разработчикам хранилищ и аналитикам, которые сами собирают витрины. Поэтому отдельной зарплатной статистики по навыку в открытых источниках нет.
Можно посмотреть на предложения работодателей. В поиске «Хабр Карьеры» по запросу DWH с указанной зарплатой 15 октября 2026 года нашлось семь вакансий, большинство с возможностью удалённой работы. Вилка в вакансии «Аналитик DWH» уровня Senior — 250 000–270 000 ₽, тимлиду команды DWH предлагали от 500 000 ₽, а младшему разработчику в направлении больших данных и хранилищ в Нижнем Новгороде — 30 000–40 800 ₽. Это суммы из объявлений, а не фактические зарплаты, и выборка слишком мала для обобщений.
Аналитику навык чаще даёт не прибавку, а другие задачи: собрать витрину самому и найти, на каком слое разошлись два отчёта. Инженеру данных умение спроектировать ядро и загрузку открывает задачи сложнее, чем запросы по готовой схеме.
Сравнить онлайн-школы можно по рейтингу онлайн-школ с обучением Data Engineering — он общий для всей инженерии данных, а не только для DWH. Перед выбором попробуйте собрать три слоя на открытых данных: так станет ясно, нужен ли вам курс по хранилищам или сначала стоит подтянуть SQL.